인공지능의 재귀적 자기 개선의 과정
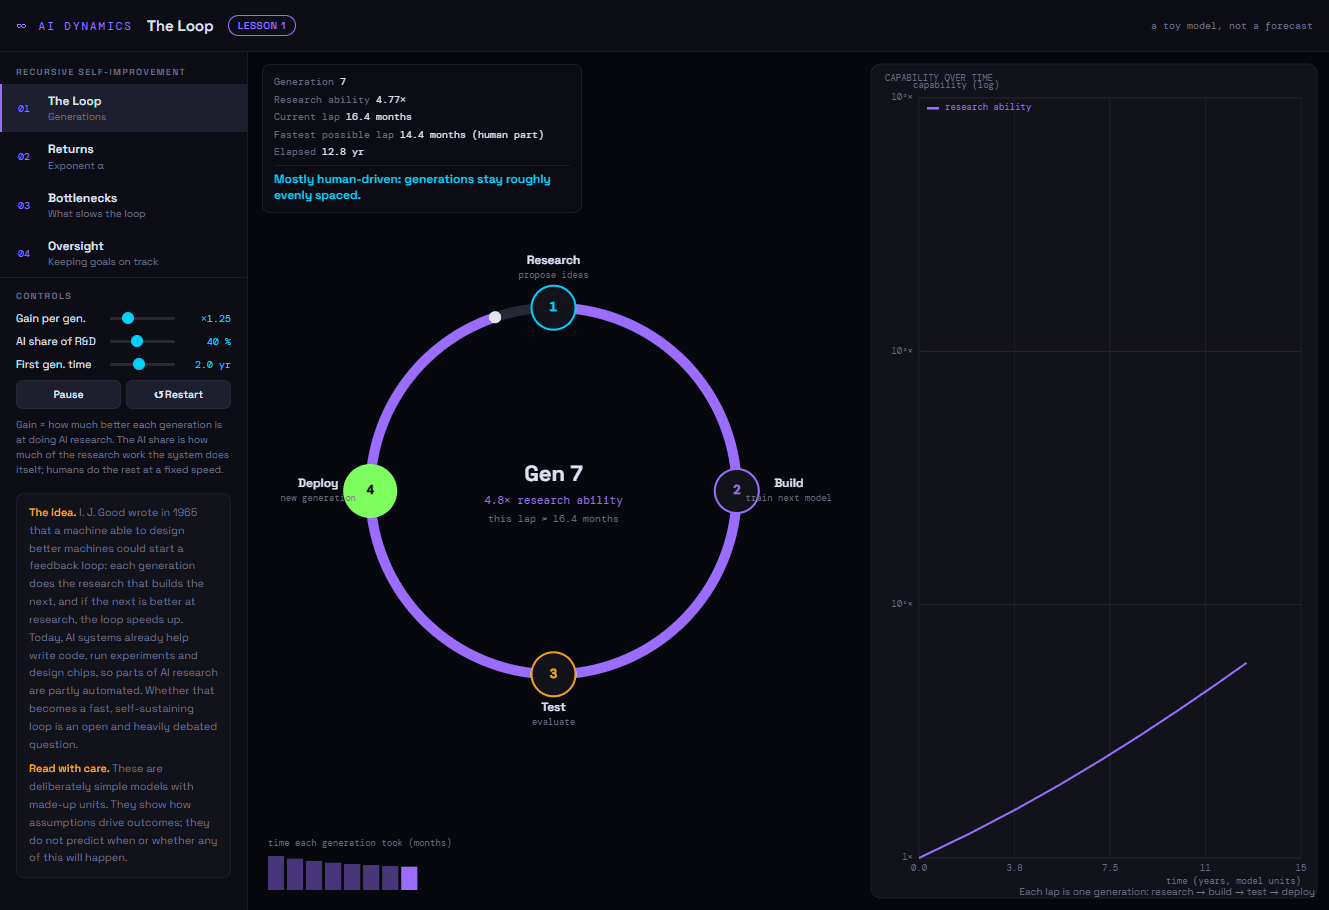
AI의 재귀적 자기 개선을 단순한 수식 모델로 직접 조작해 보는 페이지이고, 4개 레슨으로 되어 있습니다. 모든 수치는 임의 단위이고, 페이지에도 "예측이 아닌 장난감 모델"이라고 밝혀 두었습니다. The Loop : 연구 → 구축 → 테스트 → 배포를 한 바퀴(한 세대)로 애니메이션합니다. 세대당 개선 배율과 AI가 맡는 R&D 비율을 조절할 수 있습니다. 사람이 하는 몫이 남아 있으면 한 바퀴 시간에 하한이 생기고(암달의 법칙), 거의 완전 자동화되면 바퀴가 점점 빨라집니다. Returns : dI/dt = c·Iᵅ 모델로 α에 따른 차이를 보여줍니다. α < 1이면 성장이 점점 둔해지고, α = 1이면 지수 성장, α > 1이면 유한 시간 안에 발산(하드 테이크오프)합니다. 해석해와 발산 시점을 함께 표시합니다. Bottlenecks : 연산 자원(콥-더글러스 결합), 자동화할 수 없는 직렬 작업, 물리적 한계를 하나씩 켜 볼 수 있습니다. 같은 α에서도 "소프트웨어만" 곡선은 발산하는데, 병목을 켜면 연산 자원 증가 속도를 따라가는 곡선으로 꺾이는 것을 비교할 수 있습니다. Oversight : 세대마다 목표가 조금씩 어긋나고(drift), 오차가 누적됩니다. 평가가 이를 잡아내면 되돌린 뒤 다시 진행합니다. 감독 능력이 함께 커지지 않으면 탐지율이 세대가 지날수록 떨어져 놓치는 경우가 늘어나는 트레이드오프를 보여줍니다. 평가, 해석 가능성, 확장 가능한 감독, 단계적 배포 같은 안전 연구 개념도 소개합니다. • • • https://noxb.ly/uST4Li 🔗 Self-Improvement Loop noxb.ly
 量子力學·