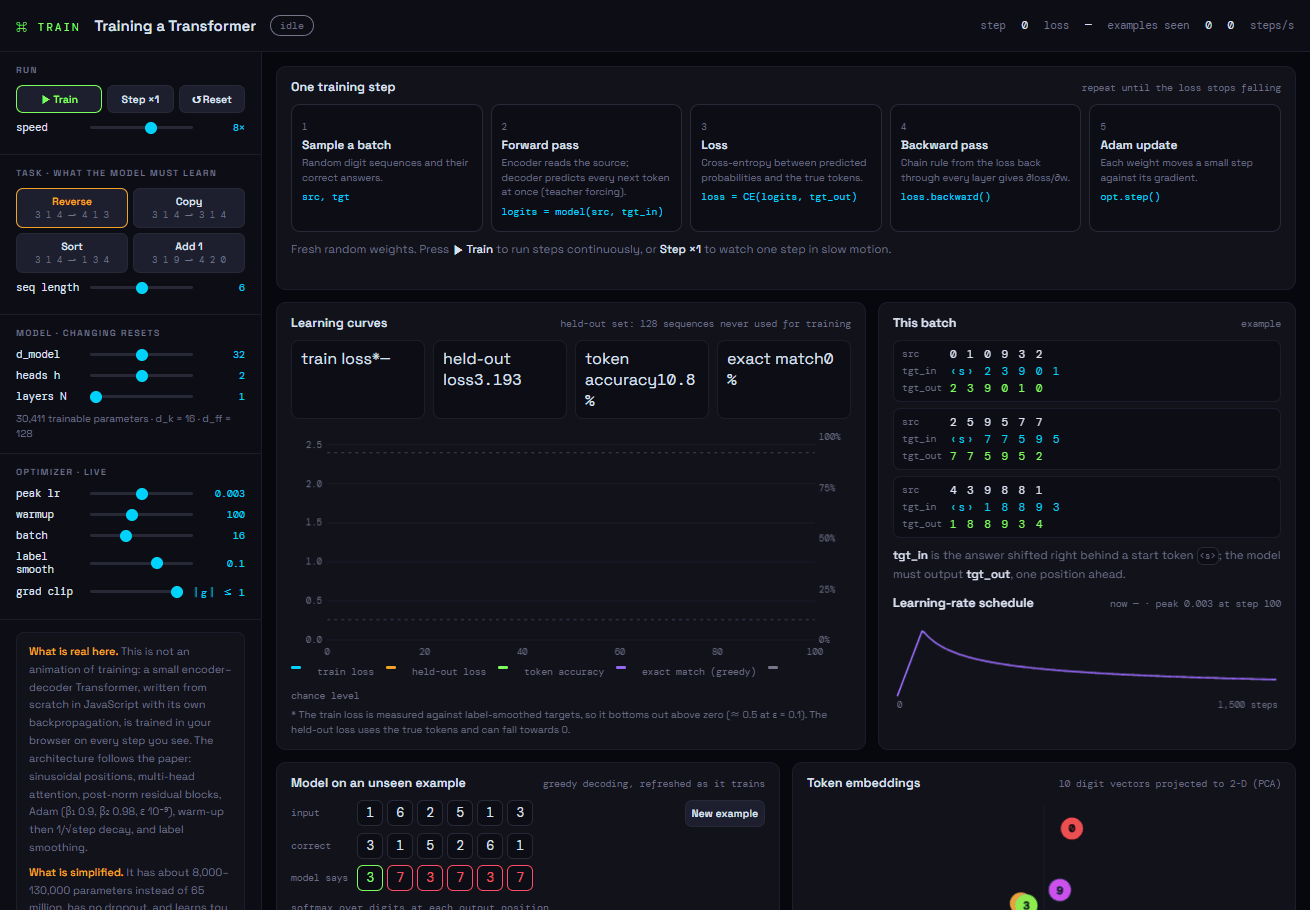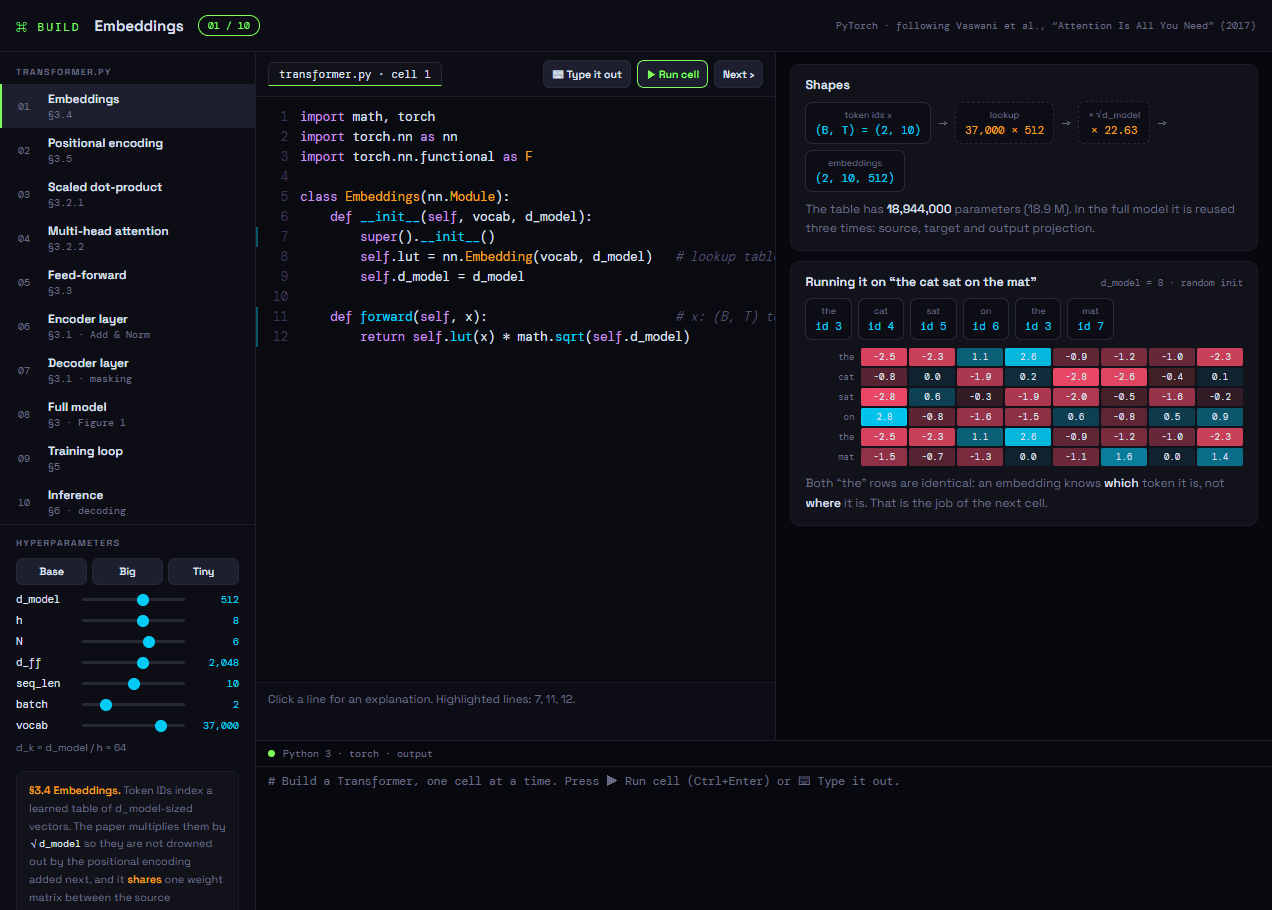

ChatGPT의 기반인 트랜스포머
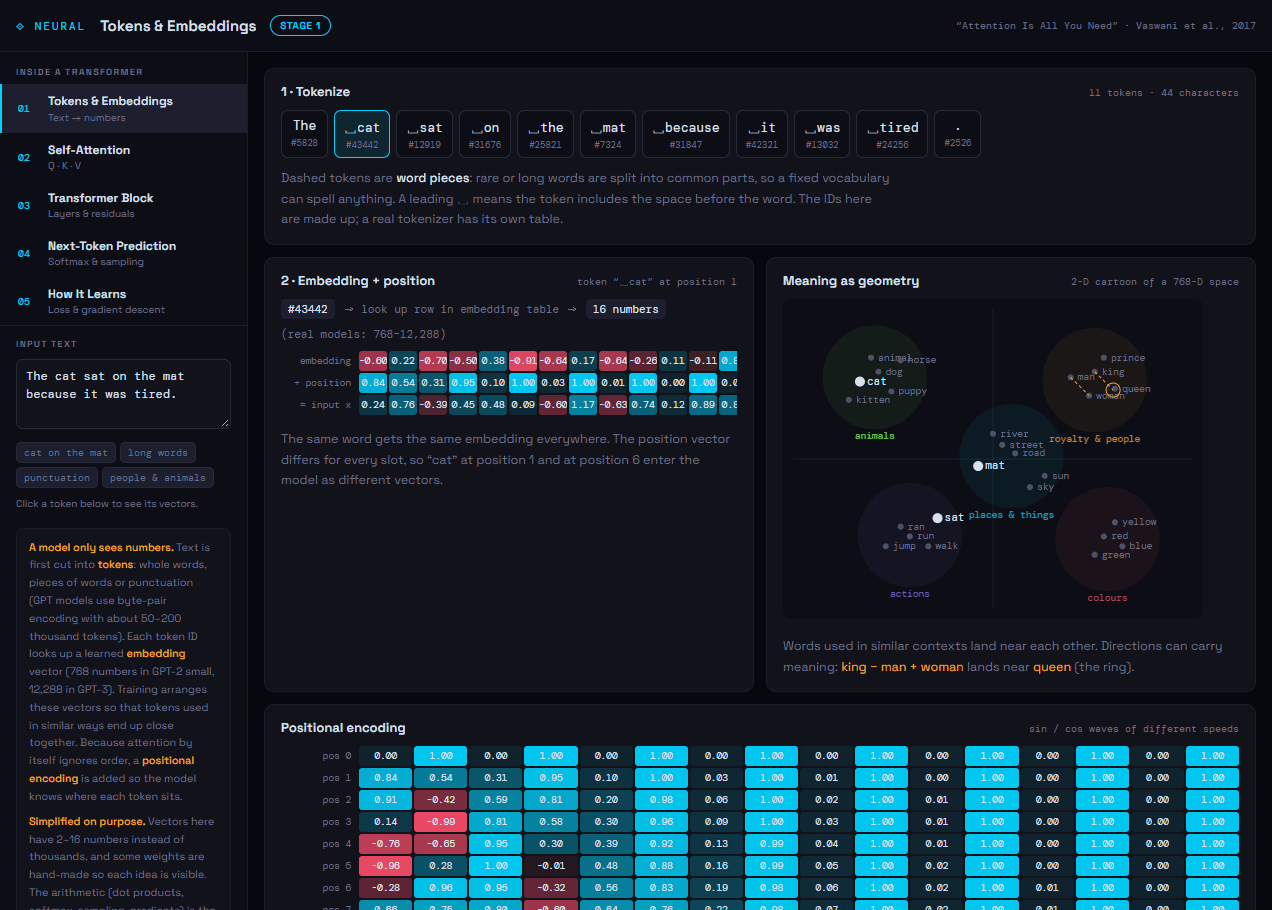
Tokens & Embeddings
입력한 문장을 토큰(긴 단어는 조각으로)으로 나누고 토큰 ID를 붙입니다.
선택한 토큰의 임베딩 벡터 + 위치 인코딩 = 입력 벡터를 히트맵으로 보여주고, sin/cos 위치 인코딩 표도 함께 그립니다.
2D 의미 지도에서 비슷한 단어들이 모여 있는 모습과 “king − man + woman ≈ queen”을 보여줍니다.
Self-Attention
Q·K·V로 실제 내적 → ÷√d → softmax를 계산합니다. 화살표, 어텐션 행렬, 선택한 행의 단계별 계산표가 나옵니다.
헤드 3개(대명사→명사, 바로 앞 토큰, 균등 평균)를 바꿔 볼 수 있습니다.
고전 예문 “The animal didn’t cross the street because it was too tired / wide”에서 “it”이 tired면 animal(75%), wide면 street(75%)를 봅니다. GPT식 인과 마스크를 켜면 뒤에 오는 형용사를 볼 수 없어서 두 단어 사이에서 애매해지는 것도 확인할 수 있습니다.
Transformer Block: LayerNorm → 멀티헤드 어텐션 → 잔차 더하기 → LayerNorm → 피드포워드 → 잔차 더하기 → ×N층 → 로짓 순서를 단계별 애니메이션으로 보여줍니다. 원조 Transformer, GPT-2, GPT-3의 규모 비교표도 있습니다.
Next-Token Prediction: 로짓, 온도를 적용한 softmax, top-k로 다음 토큰을 하나씩 샘플링해 문장을 생성합니다. 확률 막대와 엔트로피가 표시되고, 후보를 직접 골라 이어 쓸 수도 있습니다.
How It Learns: “the cat sat on the ___ → mat” 예제에서 교차 엔트로피 손실과 기울기(p − 1)를 보여주고, 경사 하강 단계마다 손실이 줄어드는 곡선을 그립니다.
설명을 위해 단순화한 부분이 있습니다.
벡터 크기는 수천 차원이 아니라 2–16차원입니다.
어텐션 헤드의 가중치는 역할이 잘 보이도록 직접 설계한 것입니다.
다음 토큰 예측은 신경망 대신 약 60문장으로 만든 작은 n-gram 모델을 씁니다.