← Back to list
활용 사례

마이크로 덕 시뮬레이터

박군

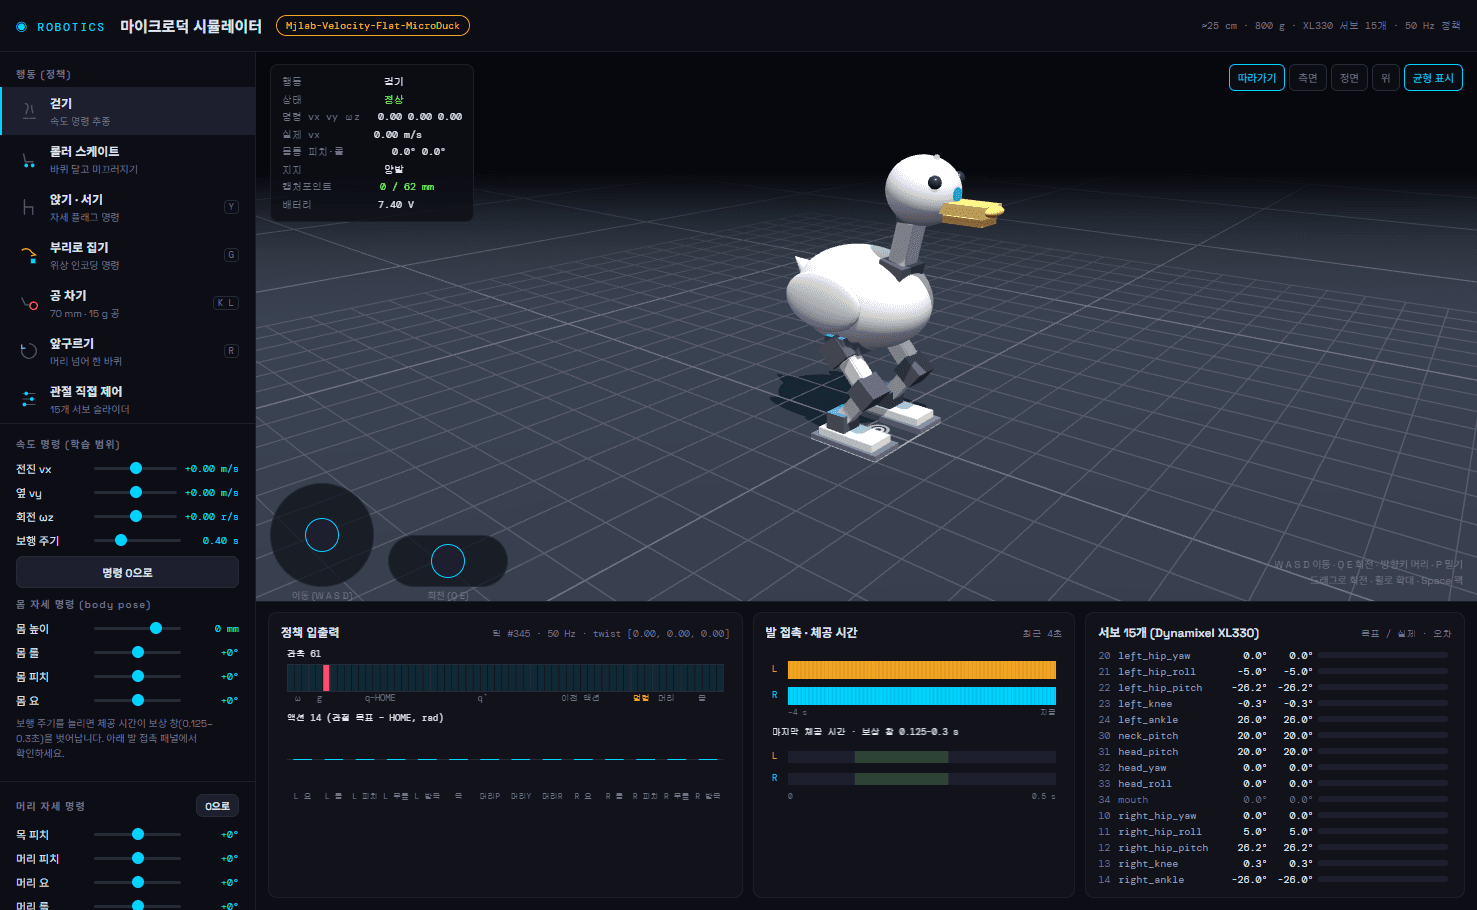
마이크로덕(Microduck)은 프랑스 로봇 기업 폴렌 로보틱스(Pollen Robotics)가 개발하고 AI 플랫폼 허깅페이스(Hugging Face)가 생태계를 지원하는 오리 모양의 소형 오픈소스 이족보행 AI 로봇입니다

미리 알아 두실 점이 있습니다. 로봇의 움직임은 학습된 ONNX 정책이나 MuJoCo 물리 시뮬레이션이 아닙니다. 그 동작을 흉내 낸 기구학 생성기(보행 위상 + 역기구학)이고, 다리 길이 같은 치수도 근사값입니다. 그래서 관절 이름·ID·한계와 HOME 값은 실제와 같지만, 자세 모양은 실제 로봇과 조금 다를 수 있습니다. 관절 직접 제어에 넣은 SIT·FOLD 키프레임은 실제 값이라 그대로 적용하면 모양이 특히 어색할 수 있습니다.

저장소에서 가져온 실제 사양

  • 서보: XL330 15개. Dynamixel ID는 왼다리 20–24, 목·머리·부리 30–34, 오른다리 10–14입니다. 부리(34)는 정책 액션에서 빠집니다.

  • 자세와 관절 한계: HOME 자세와 관절 한계를 그대로 썼고, 슬라이더 값도 실제 로봇 규약(라디안, HOME 기준 부호)입니다.

  • 정책 입출력: 50 Hz로 61차원 관측(ω, 중력, 관절 위치·속도, 이전 액션, 명령)을 넣고 14개 액션을 내는 구조를 실시간 히트맵으로 보여줍니다.

  • 학습 설정: 속도 명령 범위 vx ±0.4, vy ±0.3, ωz ±1.0, 체공 시간 보상 창 0.125–0.3초, 발 들기 2 cm, 배터리 전압 범위 6.5–8.2 V, 백래시 ±1°, 밀기 범위 ±0.3 m/s를 반영했습니다.

  • 정책 이름: 상단 태그에 모드별 실제 작업 ID(Mjlab-Velocity-Flat-MicroDuck 등)가 표시됩니다.

체험할 수 있는 행동

  • 걷기: 조이스틱이나 WASD/QE로 움직이고, 몸 자세와 머리 명령을 줄 수 있습니다. 보행 주기를 바꾸면 체공 시간이 보상 창을 벗어나는 것을 볼 수 있습니다.

  • 롤러 스케이트: 바퀴를 달고 발을 들지 않는 스위즐 동작으로 미끄러집니다.

  • 앉기·서기 (Y): 자세 플래그 명령으로 전환합니다.

  • 부리로 집기 (G): 위상 인코딩 명령이 관측 패널에서 회전하는 것을 볼 수 있습니다. 블록을 집어 문 채로 걸어 다닙니다.

  • 공 차기 (K/L): 70 mm 공을 지지발로 무게를 옮긴 뒤 찹니다.

  • 앞구르기 (R): 머리를 넘어 한 바퀴 구르고 착지합니다.

  • 넘어짐과 기립: 세게 밀어 캡처포인트가 한계(62 mm)를 넘으면 넘어지고, 스스로 일어납니다.

  • 관절 직접 제어: 15개 서보 슬라이더와 SIT·FOLD 키프레임 프리셋이 있습니다.

  • 꽥 (Space): 부리가 열리며 소리가 납니다.

헤드리스 Chromium에서 모든 모드를 돌려 스크립트 오류가 없는 것을 확인했습니다. 보행 체공 시간 180 ms(보상 창 안), 밀기 → 넘어짐 → 기립, 블록 집기, 공 차기가 모두 정상 동작했고, 모바일 폭에서 가로 스크롤도 없습니다.

Sources:

• • •

https://noxb.ly/Qe0AkT

🔗
마이크로덕 시뮬레이터
noxb.ly

https://pollen-robotics.com/microduck/
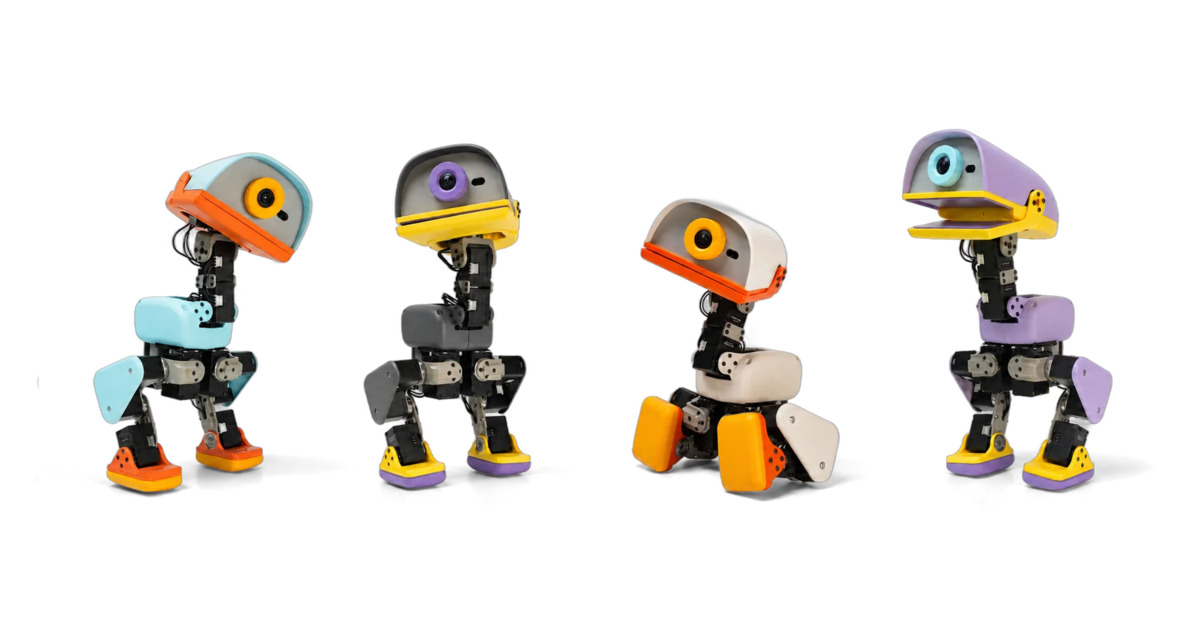
Microduck - A tiny biped robot you can teach new tricks | Pollen Robotics
Microduck is a 25 cm biped robot with 15 motors, a camera, LiDAR and a grasping beak. Playable out of the box, and its open-source stack lets you train new behaviours in simulation and run them on the robot. Pre-order at $399.
pollen-robotics.com

#edication#microduck#robotics

More in this category

트랜스포머 강화학습

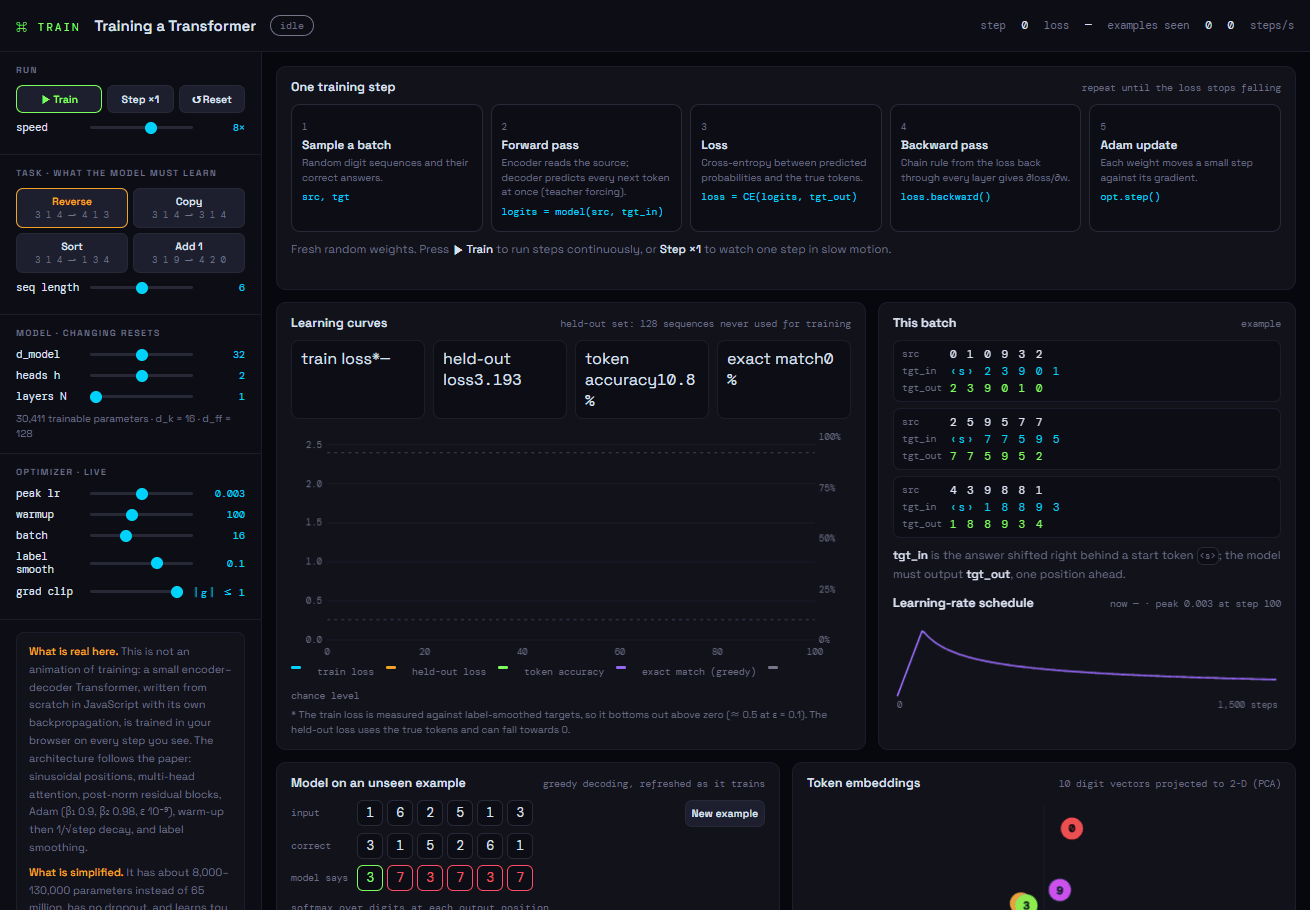
트랜스포머를 학습시키는 과정을 보여주는 시각화 자료입니다. 미리 그려 둔 애니메이션이 아니라, 브라우저 안에서 작은 트랜스포머가 실제로 학습합니다. 학습에 필요한 미분 계산(역전파)까지 JavaScript로 직접 구현했습니다. 테스트해 보니 Reverse 작업에서 약 300스텝 만에 처음 보는 문제의 정답률이 100%에 도달했습니다. 화면 구성 학습 1스텝 5단계: 배치 뽑기 → 순전파 → 손실 계산 → 역전파 → Adam 업데이트 순서로 진행됩니다. Step ×1 을 누르면 한 스텝을 느리게 돌리면서, 단계마다 실제 수치를 설명해 줍니다. 텐서 크기, 손실값, 기울기 크기, 학습률이 나옵니다. ▶ Train 을 누르면 학습이 계속 진행됩니다. 학습 곡선: 학습 손실, 학습에 쓰지 않은 데이터에서의 손실, 토큰 정확도, 문장 전체를 맞힌 비율이 실시간으로 그려집니다. 워밍업 구간도 표시됩니다. 현재 배치: 원문(src), 디코더 입력(tgt_in), 정답(tgt_out)을 나란히 보여줍니다. 디코더 입력은 정답을 한 칸씩 밀어 넣은 것(teacher forcing)입니다. 학습률 스케줄: 논문의 워밍업 후 감소 곡선 위에 현재 위치가 표시됩니다. 처음 보는 예제에 대한 예측: 모델이 한 자리씩 답을 생성하고, 자리마다 각 숫자의 확률을 보여줍니다. 어텐션 맵: 인코더, 디코더, 크로스 어텐션을 헤드별로 볼 수 있습니다. Reverse 작업이면 학습이 진행되면서 크로스 어텐션에 반대 대각선 패턴이 뚜렷하게 나타납니다. 숫자 임베딩 지도: 0~9 숫자 벡터를 2차원으로 줄여서, 학습하면서 배치가 바뀌는 모습을 보여줍니다. 기울기 흐름: 모듈마다 기울기 크기와 "업데이트 크기 ÷ 가중치 크기" 비율을 보여줍니다. 조절할 수 있는 것 작업: 뒤집기(Reverse), 복사(Copy), 정렬(Sort), 각 숫자에 1 더하기(Add 1), 그리고 수열 길이. 모델 크기: d_model, 헤드 수, 층 수. 바꾸면 처음부터 다시 학습합니다. 학습 설정: 학습률, 워밍업, 배치 크기, 라벨 스무딩, 기울기 클리핑. 학습 도중에 바꿔도 바로 반영됩니다. 휴대폰에서는 화면 아래에 Train, Step, Reset 버튼이 고정되어 있습니다. 참고할 점 모델 구조와 학습 방식은 논문을 따랐습니다. 다만 파라미터가 약 8천~13만 개로 작고, 드롭아웃이 없으며, 번역 대신 간단한 숫자 작업을 배웁니다. 학습 손실은 라벨 스무딩 때문에 약 0.5 아래로 내려가지 않습니다. 정상이며, 화면에도 이 내용을 적어 두었습니다. 정렬 작업은 다른 작업보다 어려워서 층 수를 2로 올리는 것이 좋습니다. • • • https://noxb.ly/BdjZv8 🔗 Training a Transformer noxb.ly

활용 사례量子力學·
#트랜스포머#강화학습

트랜스포머 엔진 개발

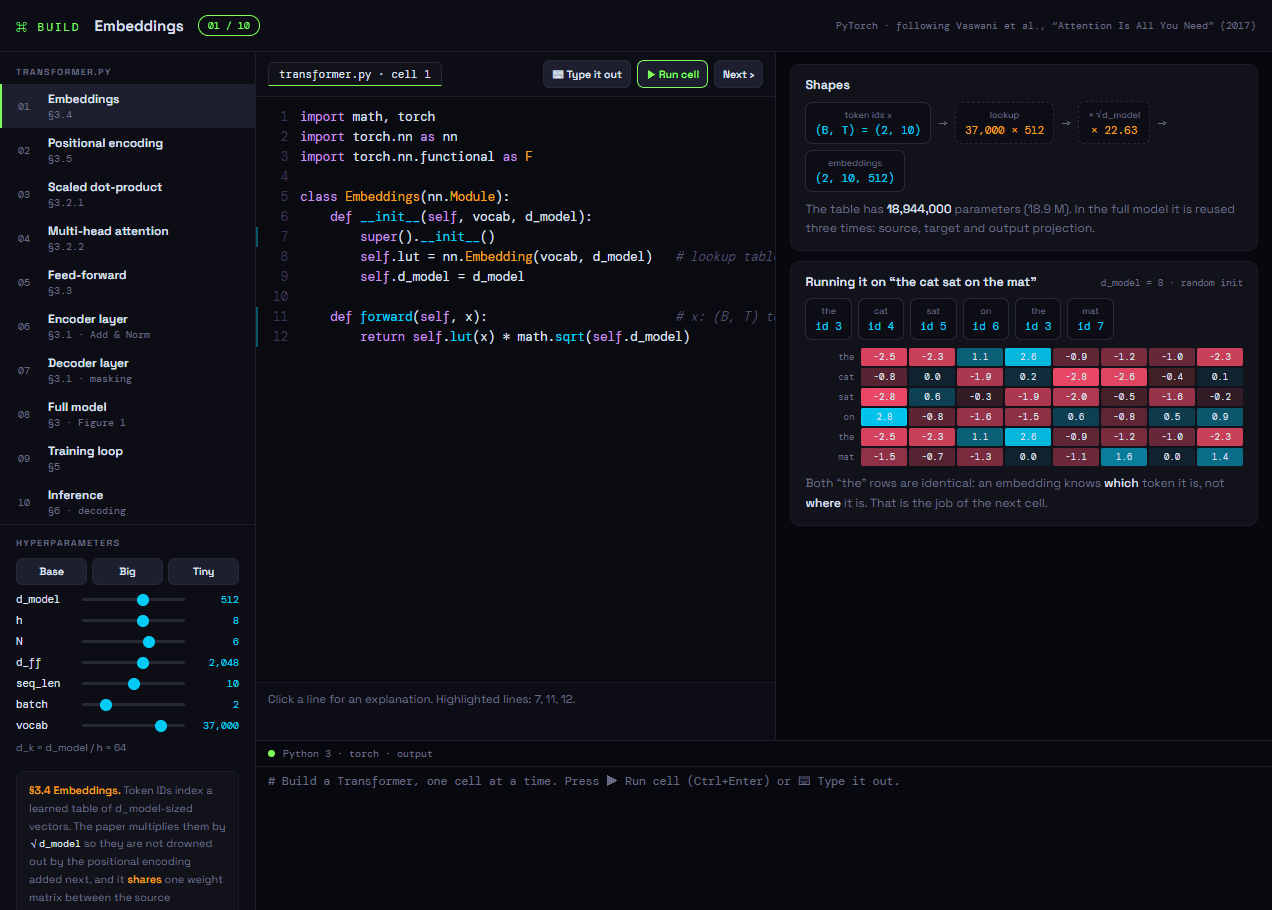
“Attention Is All You Need” 논문의 트랜스포머 원리를 개발자가 PyTorch로 한 줄씩 코딩해 가는 과정입니다. 화면 구성 왼쪽, 코드 편집기: 장마다 실행 가능한 PyTorch 코드가 있습니다. ⌨ Type it out 을 누르면 코드가 한 줄씩 타이핑되면서 중요한 줄의 설명이 같이 나옵니다. 아무 줄이나 클릭하면 그 줄이 무엇을 하는지, 텐서 모양이 어떻게 바뀌는지 보여줍니다. 오른쪽, 시각화: 텐서 모양이 바뀌는 흐름과 실제 계산값의 히트맵이 나옵니다. 히트맵은 브라우저 안에서 직접 계산하는 d_model = 8짜리 작은 트랜스포머에서 나옵니다. 아래, 콘솔: ▶ Run cell (Ctrl+Enter)을 누르면 .shape 나 파라미터 수 같은 출력이 나옵니다. 이 값은 사이드바에서 정한 하이퍼파라미터로 계산됩니다. 10개 장 임베딩 (×√d_model) 사인파 위치 인코딩 스케일드 닷-프로덕트 어텐션 멀티헤드 어텐션 (view/transpose로 헤드 분리) 피드포워드 네트워크 인코더 층 (Add & Norm) 디코더 층 (causal mask, 크로스 어텐션) 전체 모델 (임베딩과 출력층 가중치 공유) 학습 루프: Adam, 워밍업 학습률 스케줄, 라벨 스무딩, teacher forcing 추론: 그리디 디코딩을 한 단계씩 진행 하이퍼파라미터 Base / Big / Tiny 프리셋 을 고를 수 있습니다. 파라미터 수가 Base는 약 6,308만 개, Big은 약 2억 1,400만 개로 나오고, 논문의 약 6,500만·2억 1,300만 개와 거의 같습니다. d_model이 h로 나누어떨어지지 않게 설정하면(예: 512와 12) 경고가 뜨고, 콘솔에 AssertionError 가 나옵니다. 참고할 점 히트맵에 쓰인 작은 모델의 가중치는 학습되지 않은 무작위 값이라서, 어텐션 패턴 자체에는 의미가 없습니다. 추론 장에 나오는 독일어 번역 결과는 학습된 모델이 내놓을 법한 결과를 예시로 넣은 것입니다. • • • https://noxb.ly/JUMgYm 🔗 Build a Transformer noxb.ly

활용 사례量子力學·
#챗GTP#트랜스포머#엔진