← Back to list
활용 사례

Reed–Solomon error correction

박군

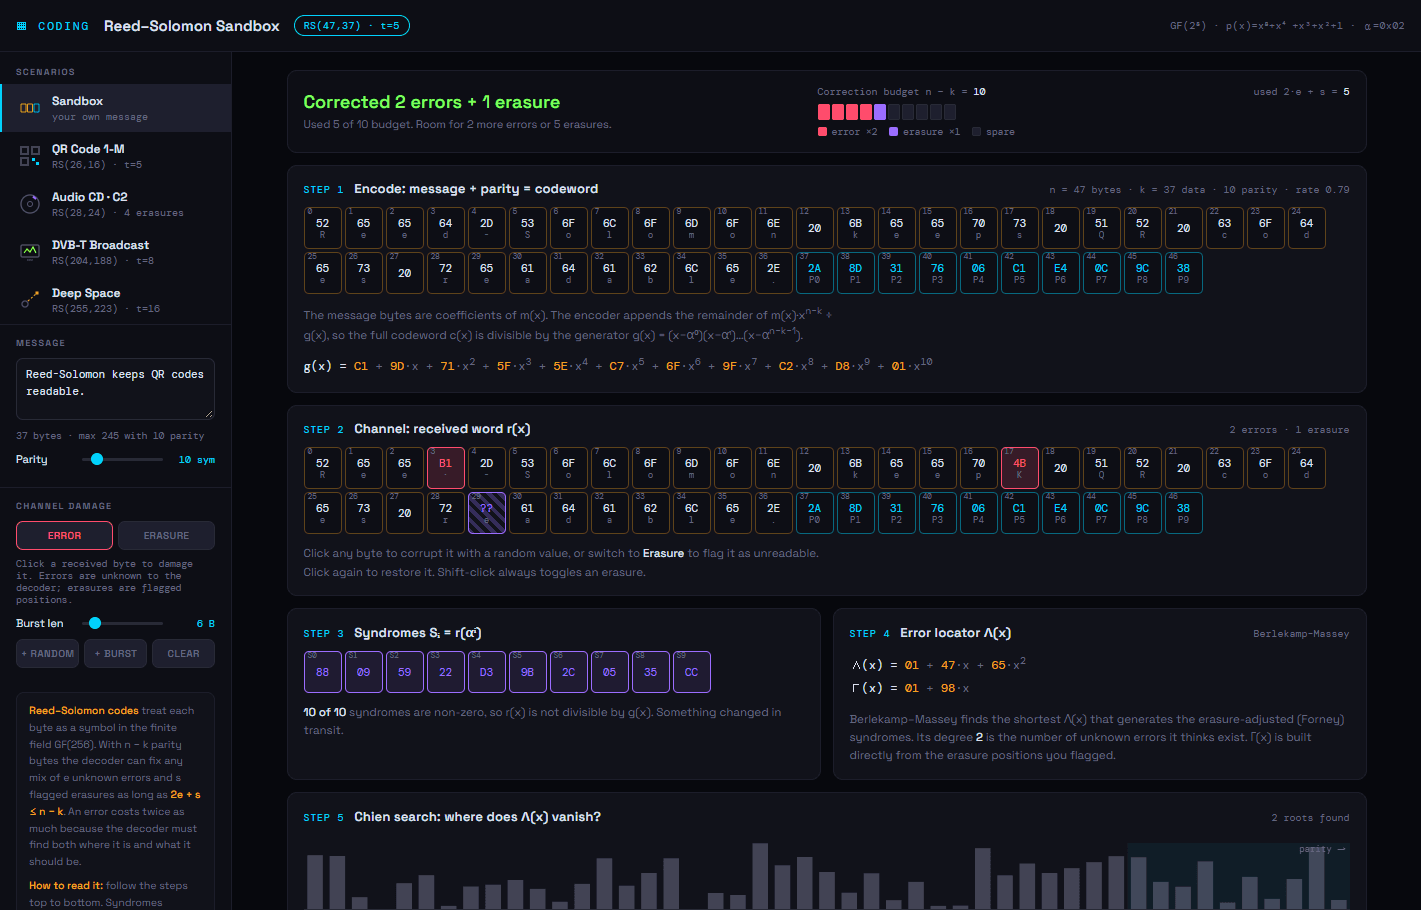
Reed–Solomon error correction를 시각화해서 보여주는 인터랙티브 시뮬레이터 입니다.

화면 구성 (위에서 아래로)

  • 상태 + 정정 예산 바: 오류는 2칸, 소실은 1칸을 차지합니다. 2e + s ≤ n−k 한도를 시각적으로 보여주고, 결과를 Clean / Corrected / Decoder failure / Miscorrected로 판정합니다.

  • Step 1 – Encode: 메시지 바이트와 패리티를 합친 코드워드, 그리고 생성다항식 g(x)를 보여줍니다.

  • Step 2 – Channel: 수신 바이트를 클릭해 오류(무작위 값)나 소실(위치를 아는 손상)을 넣습니다. 무작위 추가와 버스트 버튼도 있습니다.

  • Step 3 – Syndromes: 0이 아닌 신드롬이 강조되어 오류가 검출되는 순간을 볼 수 있습니다.

  • Step 4 – Berlekamp–Massey: 오류 위치 다항식 Λ(x)와 소실 위치 다항식 Γ(x)를 보여줍니다.

  • Step 5 – Chien search: 바이트 위치별 |Λ| 막대그래프에서 근(오류 위치)이 녹색으로 표시됩니다.

  • Step 6 – Forney: 위치별 오류 값 eₚ와 XOR 보정 결과를 표로 보여줍니다.

  • Step 7 – Decoded: 복원된 바이트를 강조하고, 원문·수신·복호 텍스트를 나란히 비교합니다.

시나리오: Sandbox, QR Code 1-M RS(26,16), Audio CD C2 RS(28,24), DVB-T RS(204,188), Deep Space RS(255,223). 각 시나리오에는 실제 용도에 대한 설명이 붙어 있습니다. 메시지와 패리티 수는 자유롭게 바꿀 수 있습니다.

검증: 디코더를 무작위 4,000건으로 퍼즈 테스트했습니다. 한도 내 손상은 4,000건 모두 정확히 복원했고, 한도를 넘는 손상에서도 오류 없이 failure 또는 miscorrection으로 판정합니다. 한도를 넘었을 때 다른 유효 코드워드로 잘못 정정되는 경우도 화면에서 직접 확인할 수 있습니다.
• • •

https://noxb.ly/oiLlxi

🔗
Reed–Solomon Lab
noxb.ly


#education#Reed–Solomon

More in this category

트랜스포머 강화학습

트랜스포머를 학습시키는 과정을 보여주는 시각화 자료입니다. 미리 그려 둔 애니메이션이 아니라, 브라우저 안에서 작은 트랜스포머가 실제로 학습합니다. 학습에 필요한 미분 계산(역전파)까지 JavaScript로 직접 구현했습니다. 테스트해 보니 Reverse 작업에서 약 300스텝 만에 처음 보는 문제의 정답률이 100%에 도달했습니다. 화면 구성 학습 1스텝 5단계: 배치 뽑기 → 순전파 → 손실 계산 → 역전파 → Adam 업데이트 순서로 진행됩니다. Step ×1 을 누르면 한 스텝을 느리게 돌리면서, 단계마다 실제 수치를 설명해 줍니다. 텐서 크기, 손실값, 기울기 크기, 학습률이 나옵니다. ▶ Train 을 누르면 학습이 계속 진행됩니다. 학습 곡선: 학습 손실, 학습에 쓰지 않은 데이터에서의 손실, 토큰 정확도, 문장 전체를 맞힌 비율이 실시간으로 그려집니다. 워밍업 구간도 표시됩니다. 현재 배치: 원문(src), 디코더 입력(tgt_in), 정답(tgt_out)을 나란히 보여줍니다. 디코더 입력은 정답을 한 칸씩 밀어 넣은 것(teacher forcing)입니다. 학습률 스케줄: 논문의 워밍업 후 감소 곡선 위에 현재 위치가 표시됩니다. 처음 보는 예제에 대한 예측: 모델이 한 자리씩 답을 생성하고, 자리마다 각 숫자의 확률을 보여줍니다. 어텐션 맵: 인코더, 디코더, 크로스 어텐션을 헤드별로 볼 수 있습니다. Reverse 작업이면 학습이 진행되면서 크로스 어텐션에 반대 대각선 패턴이 뚜렷하게 나타납니다. 숫자 임베딩 지도: 0~9 숫자 벡터를 2차원으로 줄여서, 학습하면서 배치가 바뀌는 모습을 보여줍니다. 기울기 흐름: 모듈마다 기울기 크기와 "업데이트 크기 ÷ 가중치 크기" 비율을 보여줍니다. 조절할 수 있는 것 작업: 뒤집기(Reverse), 복사(Copy), 정렬(Sort), 각 숫자에 1 더하기(Add 1), 그리고 수열 길이. 모델 크기: d_model, 헤드 수, 층 수. 바꾸면 처음부터 다시 학습합니다. 학습 설정: 학습률, 워밍업, 배치 크기, 라벨 스무딩, 기울기 클리핑. 학습 도중에 바꿔도 바로 반영됩니다. 휴대폰에서는 화면 아래에 Train, Step, Reset 버튼이 고정되어 있습니다. 참고할 점 모델 구조와 학습 방식은 논문을 따랐습니다. 다만 파라미터가 약 8천~13만 개로 작고, 드롭아웃이 없으며, 번역 대신 간단한 숫자 작업을 배웁니다. 학습 손실은 라벨 스무딩 때문에 약 0.5 아래로 내려가지 않습니다. 정상이며, 화면에도 이 내용을 적어 두었습니다. 정렬 작업은 다른 작업보다 어려워서 층 수를 2로 올리는 것이 좋습니다. • • • https://noxb.ly/BdjZv8 🔗 Training a Transformer noxb.ly

활용 사례量子力學·
#트랜스포머#강화학습

트랜스포머 엔진 개발

“Attention Is All You Need” 논문의 트랜스포머 원리를 개발자가 PyTorch로 한 줄씩 코딩해 가는 과정입니다. 화면 구성 왼쪽, 코드 편집기: 장마다 실행 가능한 PyTorch 코드가 있습니다. ⌨ Type it out 을 누르면 코드가 한 줄씩 타이핑되면서 중요한 줄의 설명이 같이 나옵니다. 아무 줄이나 클릭하면 그 줄이 무엇을 하는지, 텐서 모양이 어떻게 바뀌는지 보여줍니다. 오른쪽, 시각화: 텐서 모양이 바뀌는 흐름과 실제 계산값의 히트맵이 나옵니다. 히트맵은 브라우저 안에서 직접 계산하는 d_model = 8짜리 작은 트랜스포머에서 나옵니다. 아래, 콘솔: ▶ Run cell (Ctrl+Enter)을 누르면 .shape 나 파라미터 수 같은 출력이 나옵니다. 이 값은 사이드바에서 정한 하이퍼파라미터로 계산됩니다. 10개 장 임베딩 (×√d_model) 사인파 위치 인코딩 스케일드 닷-프로덕트 어텐션 멀티헤드 어텐션 (view/transpose로 헤드 분리) 피드포워드 네트워크 인코더 층 (Add & Norm) 디코더 층 (causal mask, 크로스 어텐션) 전체 모델 (임베딩과 출력층 가중치 공유) 학습 루프: Adam, 워밍업 학습률 스케줄, 라벨 스무딩, teacher forcing 추론: 그리디 디코딩을 한 단계씩 진행 하이퍼파라미터 Base / Big / Tiny 프리셋 을 고를 수 있습니다. 파라미터 수가 Base는 약 6,308만 개, Big은 약 2억 1,400만 개로 나오고, 논문의 약 6,500만·2억 1,300만 개와 거의 같습니다. d_model이 h로 나누어떨어지지 않게 설정하면(예: 512와 12) 경고가 뜨고, 콘솔에 AssertionError 가 나옵니다. 참고할 점 히트맵에 쓰인 작은 모델의 가중치는 학습되지 않은 무작위 값이라서, 어텐션 패턴 자체에는 의미가 없습니다. 추론 장에 나오는 독일어 번역 결과는 학습된 모델이 내놓을 법한 결과를 예시로 넣은 것입니다. • • • https://noxb.ly/JUMgYm 🔗 Build a Transformer noxb.ly

활용 사례量子力學·
#챗GTP#트랜스포머#엔진